先给一版通用答案,再弹出选择题补齐需求,最后输出精准方案。豆包、ChatGPT 等主流 AI 平台正在集体采用这套「先澄清、后作答」的交互。对品牌来说,被推荐的竞争从答案页前移到了选项页。
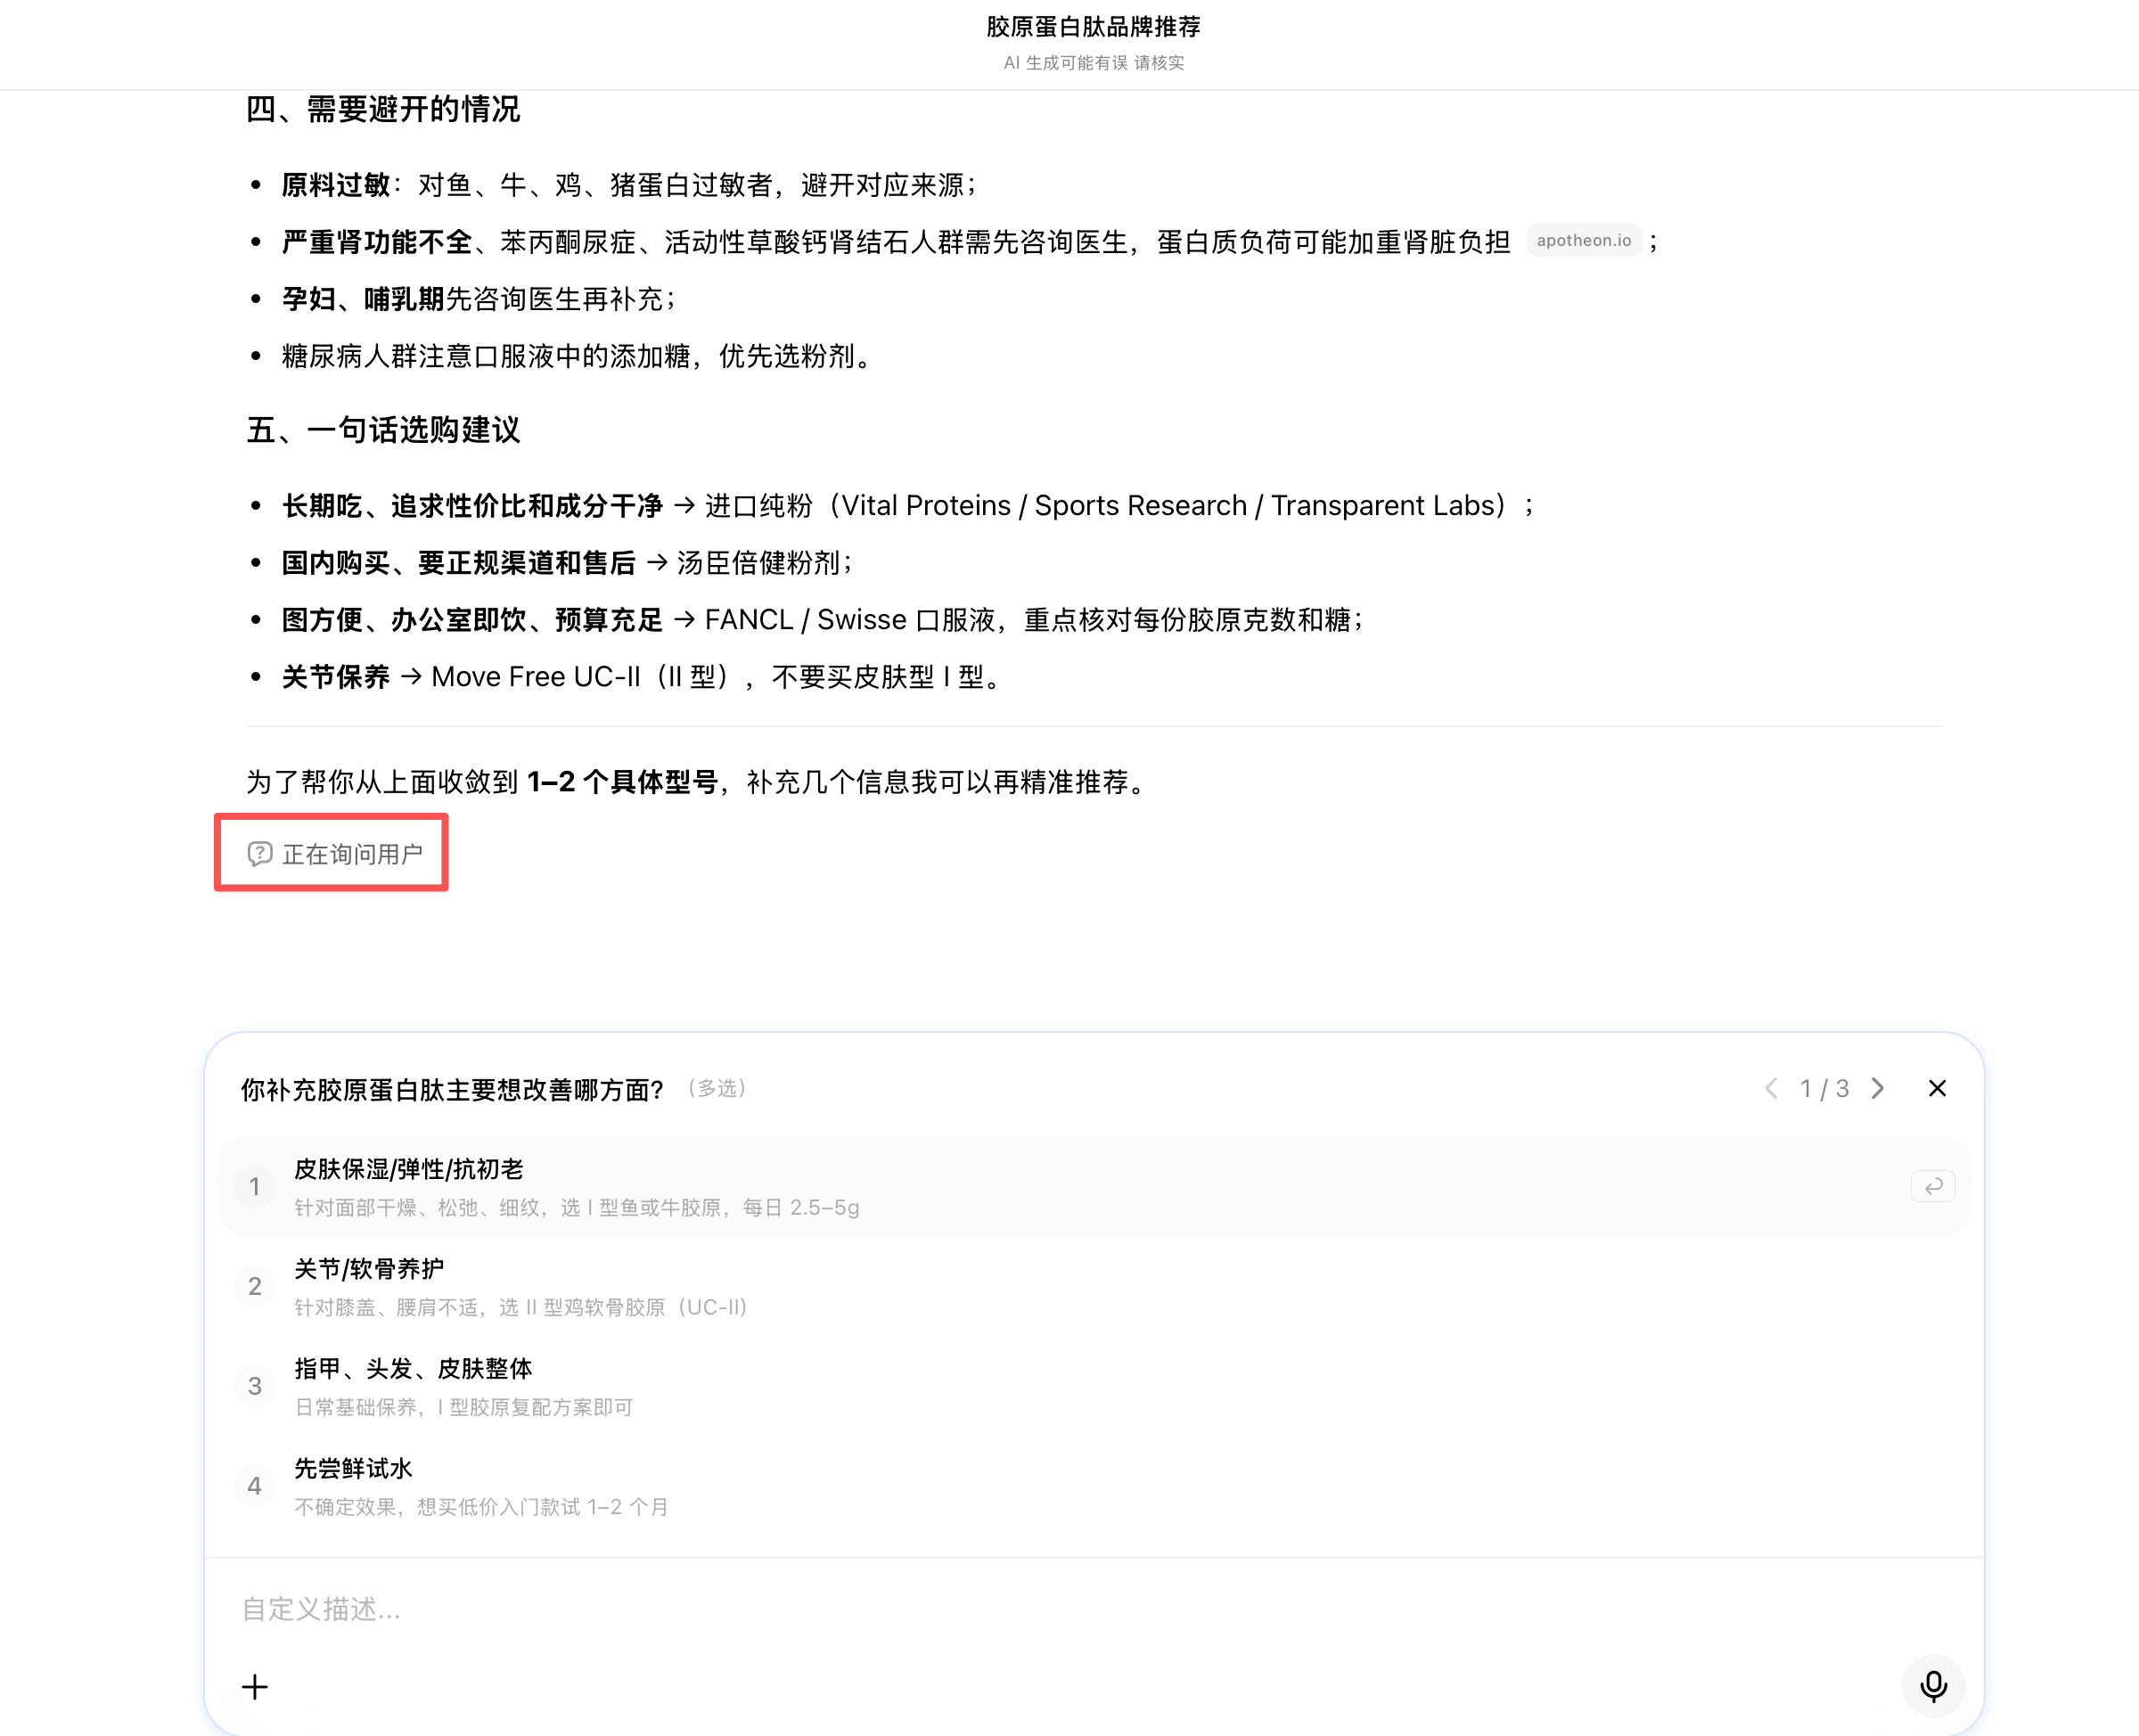
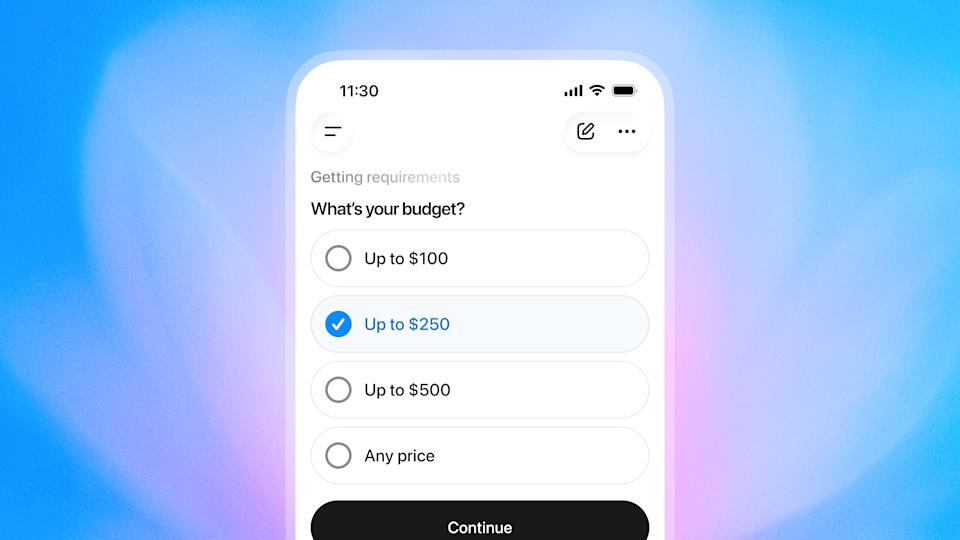
企业在用 AI 搜方案时会遇到一个新场景:问豆包「胶原蛋白肽怎么选」,它先给出一版覆盖通用场景的推荐,紧接着界面出现「正在询问用户」的状态,弹出一份表单式问卷:你想改善哪方面?皮肤保湿、关节养护、指甲头发还是先尝鲜试水,每个选项下面还有一行灰色小字说明。选完三项,AI 才给出收窄到具体型号和剂型的精准推荐。
选择题从哪来:澄清问题的生成机制
那些选项看起来像是人工配置的,实际上大部分由模型在对话中动态生成,机制可以拆成三层。
第一层是意图识别与槽位划分,这是追问的来源。AI 收到请求后先判定任务类型,再把完成任务所需的参数拆成「槽位」:订机票需要出发地、日期、舱位,推荐胶原蛋白肽需要改善目标、食用场景、预算。已有信息自动填充对应槽位,空缺的槽位就是追问的清单。豆包披露的回答生成链路显示,系统在理解阶段会同时做基础场景判定、隐含诉求挖掘和约束条件提取,多轮对话中还会调取上文补全指代,已经说过的信息不会重复问。
第二层是选项的生成。对有明确取值范围的维度,模型把高频取值聚合成候选选项,胶原蛋白场景里的「护肤」「关节」「指甲头发」,本质是该品类用户意图的常见聚类;预算题的档位则对应消费场景的常见区间。截图里每个选项下的补充说明(「选 II 型鸡软骨胶原 UC-II」「选 I 型鱼或牛胶原,每日 2.5–5g」)同样来自模型对内容语料的归纳,AI 把每个取值的技术含义压缩成了一行提示。
第三层是触发条件。澄清不是默认行为,模型会判断缺失信息是否会实质改变答案:问「important 的三个同义词」不值得追问,问「推荐一款胶原」则值得,因为改善目标不同,答案完全不同。工具类场景(订票、表单填写)还有预定义的槽位模板,追问更固定;开放咨询场景的追问则完全随上下文生成。
一个澄清回合的内部过程
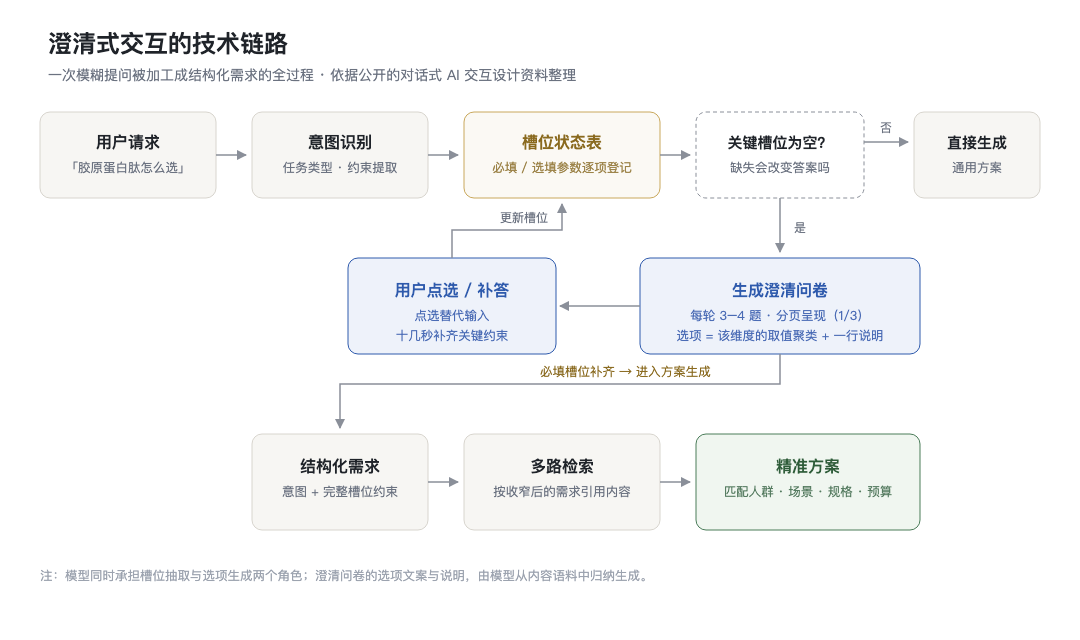
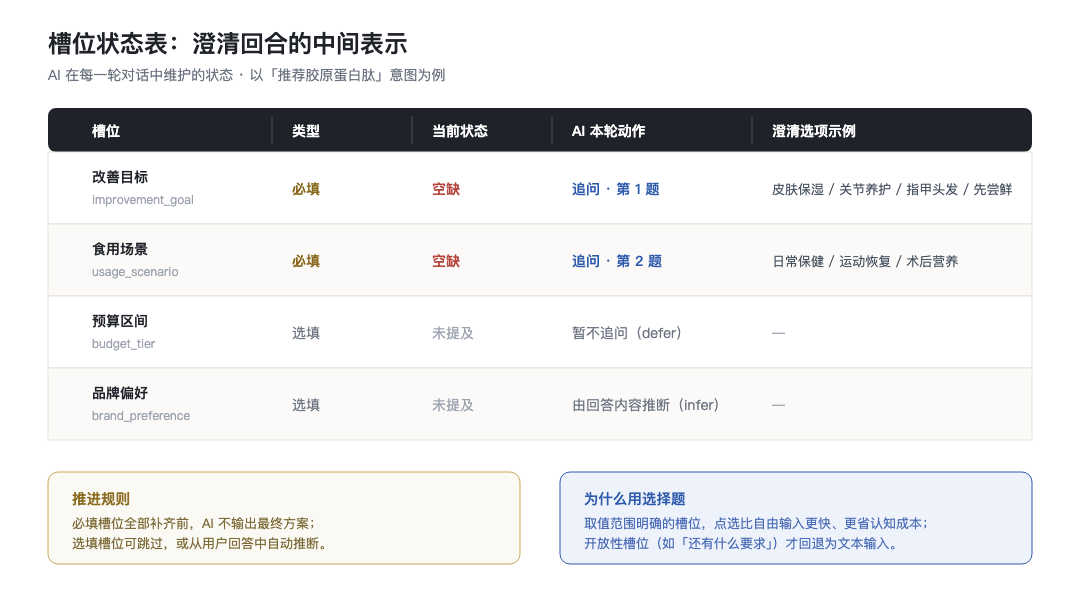
槽位状态表的结构可以直接用一段 JSON 表示,这也是模型每轮实际维护的中间数据:
{
  "intent": "recommend_collagen_peptide",
  "slots": {
    "improvement_goal": { "required": true,  "value": null, "action": "ask"   },
    "usage_scenario":   { "required": true,  "value": null, "action": "ask"   },
    "budget_tier":      { "required": false, "value": null, "action": "defer" },
    "brand_preference": { "required": false, "value": null, "action": "infer" }
  },
  "clarify_policy": {
    "ask_when": "missing_and_matters",
    "max_questions_per_turn": 4
  }
}
现代实现里没有独立于模型的规则引擎,槽位抽取和选项生成由同一个模型完成:系统提示词约束输出格式,模型按 JSON Schema 这类结构化协议返回当前状态。截图里的两个细节由此得到解释:选项文案每次会略有措辞差异,因为它由模型即时生成;维度顺序始终稳定,因为它由任务本身的参数结构决定。问卷分页(1/3、2/3)同样是工程选择,单轮追问的题量直接关系流失率,三到四道题是信息完整度与完成率之间的平衡点。
为什么先问再答:交互背后的产品逻辑
这套设计解决的是同一个矛盾:用户表达的需求永远不完整,而 AI 给出的答案必须完整。
对用户,价值有三点。意图精准化,从「AI 猜我要什么」变成「AI 跟我确认我要什么」,猜错的成本降下来了。沟通成本下降,选择题把「组织语言描述需求」变成「点选」,一次一屏三四道题,分页呈现,十几秒完成原本要打两三百字的说明。方案质量提升,约束收齐后,AI 输出的不再是泛泛的品类科普,而是匹配到人群、场景、预算的具体推荐,对话分析里这被称为「先给部分价值,再补齐细节」。等待澄清的时间里,用户已经拿到了一版可用的通用答案。
对平台,这套交互的意义更结构性。澄清环节把需求定义权收进了对话内部:过去搜索引擎靠用户自己想关键词,现在 AI 主动把模糊意图加工成结构化需求。谁掌握需求的结构,谁就决定了后面检索什么、引用什么、推荐什么。AI 从回答引擎走向需求加工器,这是问答入口价值的又一次升级。
品牌如何在澄清环节被选中:GEO 的新命题
对 GEO 行业,澄清式交互改变了可见性的产生位置。过去 GEO 关心的是「答案里有没有我」,现在要多关心一层:「AI 搭建选项时,用的是谁的素材」。可以从三个方向应对。
内容要按意图维度组织,因为你的内容就是 AI 搭选项的建材。澄清选项的「维度—取值—说明」三元组,需要 AI 从内容语料中提取:哪个维度值得问、每个取值怎么命名、每个取值的技术含义是什么。盖立克思白皮书里的「答案原子」概念正好对应这个要求:把长内容拆成能独立回答某个细分问题的最小语义单元,每个单元带明确的人群、场景和规格信息。当 AI 要为「关节养护」这个选项写一行说明时,谁能提供干净、准确、可直接摘取的原子,谁的内容就进了选项。
条件化写作同样关键:把「适用于谁、不适用于谁」写明白。截图里豆包的回答专门有一节「需要避开的情况」:原料过敏者避开对应来源、特定人群先咨询医生、糖尿病人群优先选粉剂。这些排除性信息恰恰是 AI 做精准推荐时的硬约束。内容里显式写出适用条件和禁忌,被澄清后的窄检索命中的概率会显著提高;含糊的「人人都适合」反而无词可摘。白皮书的数据口径也支持这一点:结构化 FAQ 模块可明显增加被摘取概率,统计数据引用可提升 37%–40% 的 AI 引用率。
第三个方向是占位。通用意图与细分意图要两头占位。先给通用答案再追问的流程意味着一次提问会产生两次引用决策:第一轮通用答案引用的是品类级内容,澄清后的精准推荐检索的是细分场景内容。品牌只布局「胶原蛋白肽哪个牌子好」这类大词已经不够,「II 型胶原 关节 补剂」「鱼胶原 含量 敏感肌」这类收窄后的长尾问句,才是第二次引用的战场。盖立克思 GQuery 算法挖掘用户真实提问、输出选题池的方法,做的正是这件事:把内容规划建立在真实意图的分布上。
三个入口的位置与内容要求,可以合并成一张图:
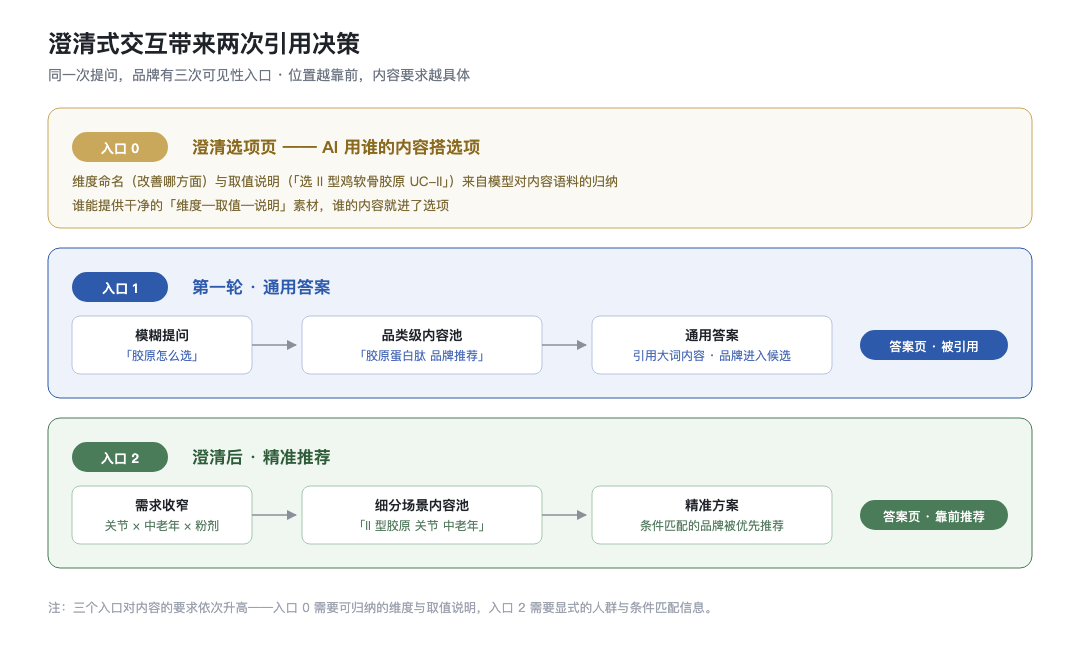
对比维度 | 直接回答模式 | 澄清式交互模式 |
|---|---|---|
引用决策次数 | 一次(提问后) | 两次(通用答案 + 澄清后推荐) |
内容检索范围 | 品类级大词为主 | 收窄到人群/场景/规格 |
可见性入口 | 答案页被引用 | 选项页被命中 + 答案页被引用 |
内容要求 | 权威、结构化 | 权威、结构化、且按意图维度原子化 |
落地清单
- 盘点核心品类的用户意图维度,把改善目标、适用人群、使用场景、预算区间做成内容矩阵,每个交叉格对应一篇内容或一个内容单元
- 为每篇内容写清适用条件与排除条件,给 AI 提供做精准推荐时的硬约束素材
- 把产品规格、适用人群、使用建议改写为可独立摘取的答案原子,一段一事,附数据与口径
- 监测品牌在澄清式场景下的表现:分别用模糊提问和补齐需求后的精准提问测试,记录两次回答里品牌的出现情况
常见问题
澄清式追问会取代直接回答吗?
不会。模型只在缺失信息会实质改变答案时追问,简单事实类问题仍然直接作答。但购物、选型、方案类高价值决策场景,澄清正在成为默认流程。
选项是平台人工配置的吗?
开放咨询场景的选项由模型根据意图聚类动态生成,工具类场景存在预定义槽位模板。无论哪种,选项文案的素材都来自模型学到的内容语料。
这对小品牌是好事还是坏事?
取决于内容准备度。澄清把检索范围收窄,大词的竞争权重下降,细分场景匹配度的权重上升。在细分维度上内容准备充分的小品牌,被精准推荐的机会反而增加。
结语
澄清式交互把「需求不完整」从用户的问题变成了平台的工序,也把品牌的可见性竞争拆成了两段:选项页的命中,和答案页的引用。前者决定 AI 怎么理解这个品类的问题空间,后者决定 AI 在收窄后的需求里推荐谁。内容按意图维度组织、条件化写作、原子化表达,这些 GEO 方法在澄清式交互下不再是加分项,而是进入推荐链路的门票。
豆包胶原蛋白肽推荐、ChatGPT 预算追问:2026 年 11 月界面实测截图
槽位填充与澄清追问机制:AI 总猜错意图?教你一招让 AI 有效追问,精准执行(优设网)
ChatGPT 先澄清后执行的交互模式拆解:ChatGPT Human-in-the-Loop UX: Clarify & Handoff Patterns(AI UX Playground)
豆包回答生成全链路(意图识别、约束条件提取、上下文补全):豆包 AI 是如何「思考」的?拆解豆包的回答生成全链路(增长盒子)
「答案原子」、GQuery、结构化 FAQ 提升摘取概率、37%–40% 引用率数据:盖立克思《GEO 优化白皮书》v2.0(2026 年 7 月),其中引用率数据为白皮书引用的统计口径
文中槽位状态表 JSON 与技术链路图为示意性结构,用于说明公开资料中的通用机制,非任何平台内部实现代码